Cómo crear un conversor de iconos 2D a 3D con Stable Diffusion y Dreambooth


Los modelos de difusión de texto a imagen han supuesto un avance importante en el desarrollo de la IA, así que tenemos muchas ganas de aplicarlos en proyectos reales. Las imágenes sintetizadas te impresionarán por su visión "artística" y su fotorrealismo. Sin embargo, en nuestro campo, el diseño web, estas imágenes siguen siendo más un entretenimiento que otra cosa. Solo en casos muy concretos pueden acabar como ilustraciones en una página. Nosotros buscamos un resultado más predecible y un enfoque sistemático y personalizado para generar las ilustraciones de todo un sitio con un mismo estilo uniforme.
Por supuesto, es posible desarrollar una plantilla de prompt propia que genere imágenes variadas con un estilo predecible (puedes ver ejemplos aquí). Es un viaje largo e interesante en busca del estilo "correcto", pero no siempre lleva al resultado deseado. El motivo es el conjunto de datos limitado con el que se entrena la red neuronal. En diseño web hay muchos temas de nicho, y los modelos por defecto son demasiado generales para esos matices. Incluso algo aparentemente tan sencillo como elegir el aspecto de un botón para una landing page deja ver lo distinto que ven el mundo un diseñador web y un modelo.
En lugar de pulir un prompt, hay una forma más sencilla de canalizar la desbordante imaginación de la IA hacia un área concreta de una tarea gráfica: el fine-tune, es decir, reentrenar el modelo con un pequeño conjunto de imágenes. Puedes añadir al vocabulario de la IA un elemento concreto, como tu propia cara (como hace la popular app Lensa), un objeto o un estilo de ilustración: lo que más te interese.

Elegir un estilo
Para entrenar un modelo en un estilo concreto necesitas al menos 20 imágenes distintas. Buscando un dataset de entrenamiento, me topé con los nuevos y fantásticos emojis Fluent UI de Microsoft y vi claro que eran justo lo que necesitaba. Primero, porque hay muchísimas imágenes con el mismo estilo para hacer pruebas con datasets de distintos tamaños (gracias, Microsoft, por publicar todos los emojis en abierto). Y segundo, porque este estilo de iconos 3D es moderno y versátil. Como diseñadores web, podríamos usarlo más adelante para crear iconos nuevos o pequeñas ilustraciones sobre cualquier tema.

En GitHub, las versiones 3D de los iconos están subidas a una resolución de 256x256 píxeles, que no es suficiente para el entrenamiento, así que además las escalé a 512x512 con SwinIR_4x en la interfaz web AUTOMATIC 1111.
Fine-tune
Hicimos nuestro primer fine-tune con Dreambooth sobre un modelo de Stable Diffusion, ya que hoy por hoy es el método más sencillo y eficaz.
El entrenamiento exige muchos recursos de computación, en concreto una tarjeta gráfica muy potente y mucha memoria de vídeo. También lleva mucho tiempo: desde varias horas hasta varios días. Por eso, tras varios intentos fallidos, descartamos entrenarlo en una máquina local y recurrimos a servicios de computación en la nube.
Lancé el fine-tune de Dreambooth en dos servicios, Google Colab y runpod.io, con distintos ajustes y tamaños de dataset.
Al final obtuve cuatro modelos:
MS_emoji_v1_30img.ckpt: el primero. Un dataset de 30 emojis (entrenado en Google Colab a partir del modelo original sd-v1-4.ckpt de 4 GB), con 30 imágenes y 3000 pasos de entrenamiento.
MS_emoji_v2_30img: el mismo dataset de 30 emojis y 3000 pasos de entrenamiento. Los siguientes modelos los entrené a mano en www.runpod.io (1 x RTX A5000, 8 vCPU, 29 GB de RAM), a partir del modelo original SD v1-5-pruned.ckpt de 7,5 GB preparado para reentrenar (tutorial). A diferencia de Colab, runpod permite aportar un dataset de REGULARIZATION IMAGES. No acabé de entender para qué sirve; al parecer, son imágenes sobre un tema concreto que la red neuronal ya conoce (porque ya las ha generado antes). Pero no entendía cómo sabe la red que ya las conoce, así que descargué el dataset por defecto; como los prompts no van incrustados en los PNG, subí un dataset de 1000 emojis originales de Microsoft.

MS_emoji_v3_50img: un dataset de 50 emojis distintos de los del primero. El modelo se entrenó durante 5000 pasos. Todos los emojis debían escalarse de 256x256 a 512x512 antes del entrenamiento, pero con este modelo me equivoqué de carpeta y lo entrené con las imágenes de 256x256. El modelo aprendió que las imágenes debían verse borrosas y comprimidas =)

MS_emoji_v4_850img: el dataset más grande, con 850 emojis. Eliminé a mano las imágenes demasiado complejas o demasiado simples, además de todas las personas y caras, para quedarme solo con objetos y animales. El modelo estuvo entrenando dos días (para que te hagas una idea, los demás tardaron entre 2 y 4 horas).

También modifiqué ligeramente el conjunto de REGULARIZATION IMAGES: a los 1000 emojis anteriores les añadí 370 imágenes sencillas generadas con SD 1.5, que creé expresamente con un estilo parecido. Nunca quedó claro si esto influyó en el resultado.

Pruebas de txt2img
Probé cómo genera imágenes cada modelo con la misma semilla y el mismo prompt.


Las pruebas de txt2img mostraron que los modelos entrenados con datasets de 30 y 50 imágenes dan los mejores resultados. En cambio, el modelo MS_emoji_v4_850img generaba resultados abstractos que rara vez mostraban lo que se le pedía.
Pruebas de img2img
Stable Diffusion tiene la gran capacidad de generar imágenes no solo a partir de un texto, sino también a partir de una imagen de entrada a la que se le aplica cierta cantidad de ruido (Denoising strength). Después, SD intenta restaurar la imagen teniendo en cuenta el prompt introducido.
Al probar los modelos MS_emoji en img2img obtuve resultados muy interesantes. En concreto, con valores bajos de Denoising strength y usando ilustraciones planas como entrada, se puede conseguir una imagen bastante parecida, ¡pero en 3D! Con valores bajos de Denoising strength, Stable Diffusion intenta reproducir la imagen original lo más fielmente posible, incluido el color. Por eso, los característicos brillos violetas de los emojis de Microsoft (que puedes ver en las versiones de txt2img) desaparecen con valores bajos de DS, aunque el volumen lo añade muy bien.
Con valores altos de Denoising strength, los modelos generan variaciones de forma interesantes y el brillo violeta característico vuelve a aparecer.


El dataset Fluent UI de Microsoft en GitHub incluye varias versiones de cada imagen, en estilo 2D y 3D. Me pareció interesante comparar el resultado de la IA con la ilustración 3D original de Microsoft, introduciendo en el modelo de SD la versión plana original del emoji.


Los resultados tienen buena pinta y se parecen bastante a las imágenes 3D originales, aunque faltan los típicos brillos violetas de los emojis de Microsoft. Aun así, conseguimos un conversor de estilo 2D a 3D versátil que no se aparta de la paleta de colores original.
Los modelos funcionan bien para convertir a 3D ilustraciones 2D con relleno sólido y sin contornos. El que mejor rinde es MS_emoji_v4_850img: conserva los detalles y da resultados excelentes incluso con un valor de denoising de 0,5. Las imágenes 3D generadas se parecen a los emojis originales de Microsoft, aunque sin sus característicos brillos violetas.
100 iconos
Tenía curiosidad por probar la transformación de 2D a 3D con un número mayor de imágenes. Encontré un pack de 100 iconos 2D a color de icons8.com que encajaba con el estilo y, con Batch img2img de la interfaz web AUTOMATIC 1111, los procesé todos con los ajustes anteriores.
Los resultados variaban según la imagen original, así que generé 16 versiones de cada una y elegí a mano las mejores. Estaría genial automatizar esta selección, pero todavía no he dado con la forma. Además, SD no gestiona el canal alfa, así que tuve que recurrir a un programa mágico para quitar el fondo blanco de las imágenes.
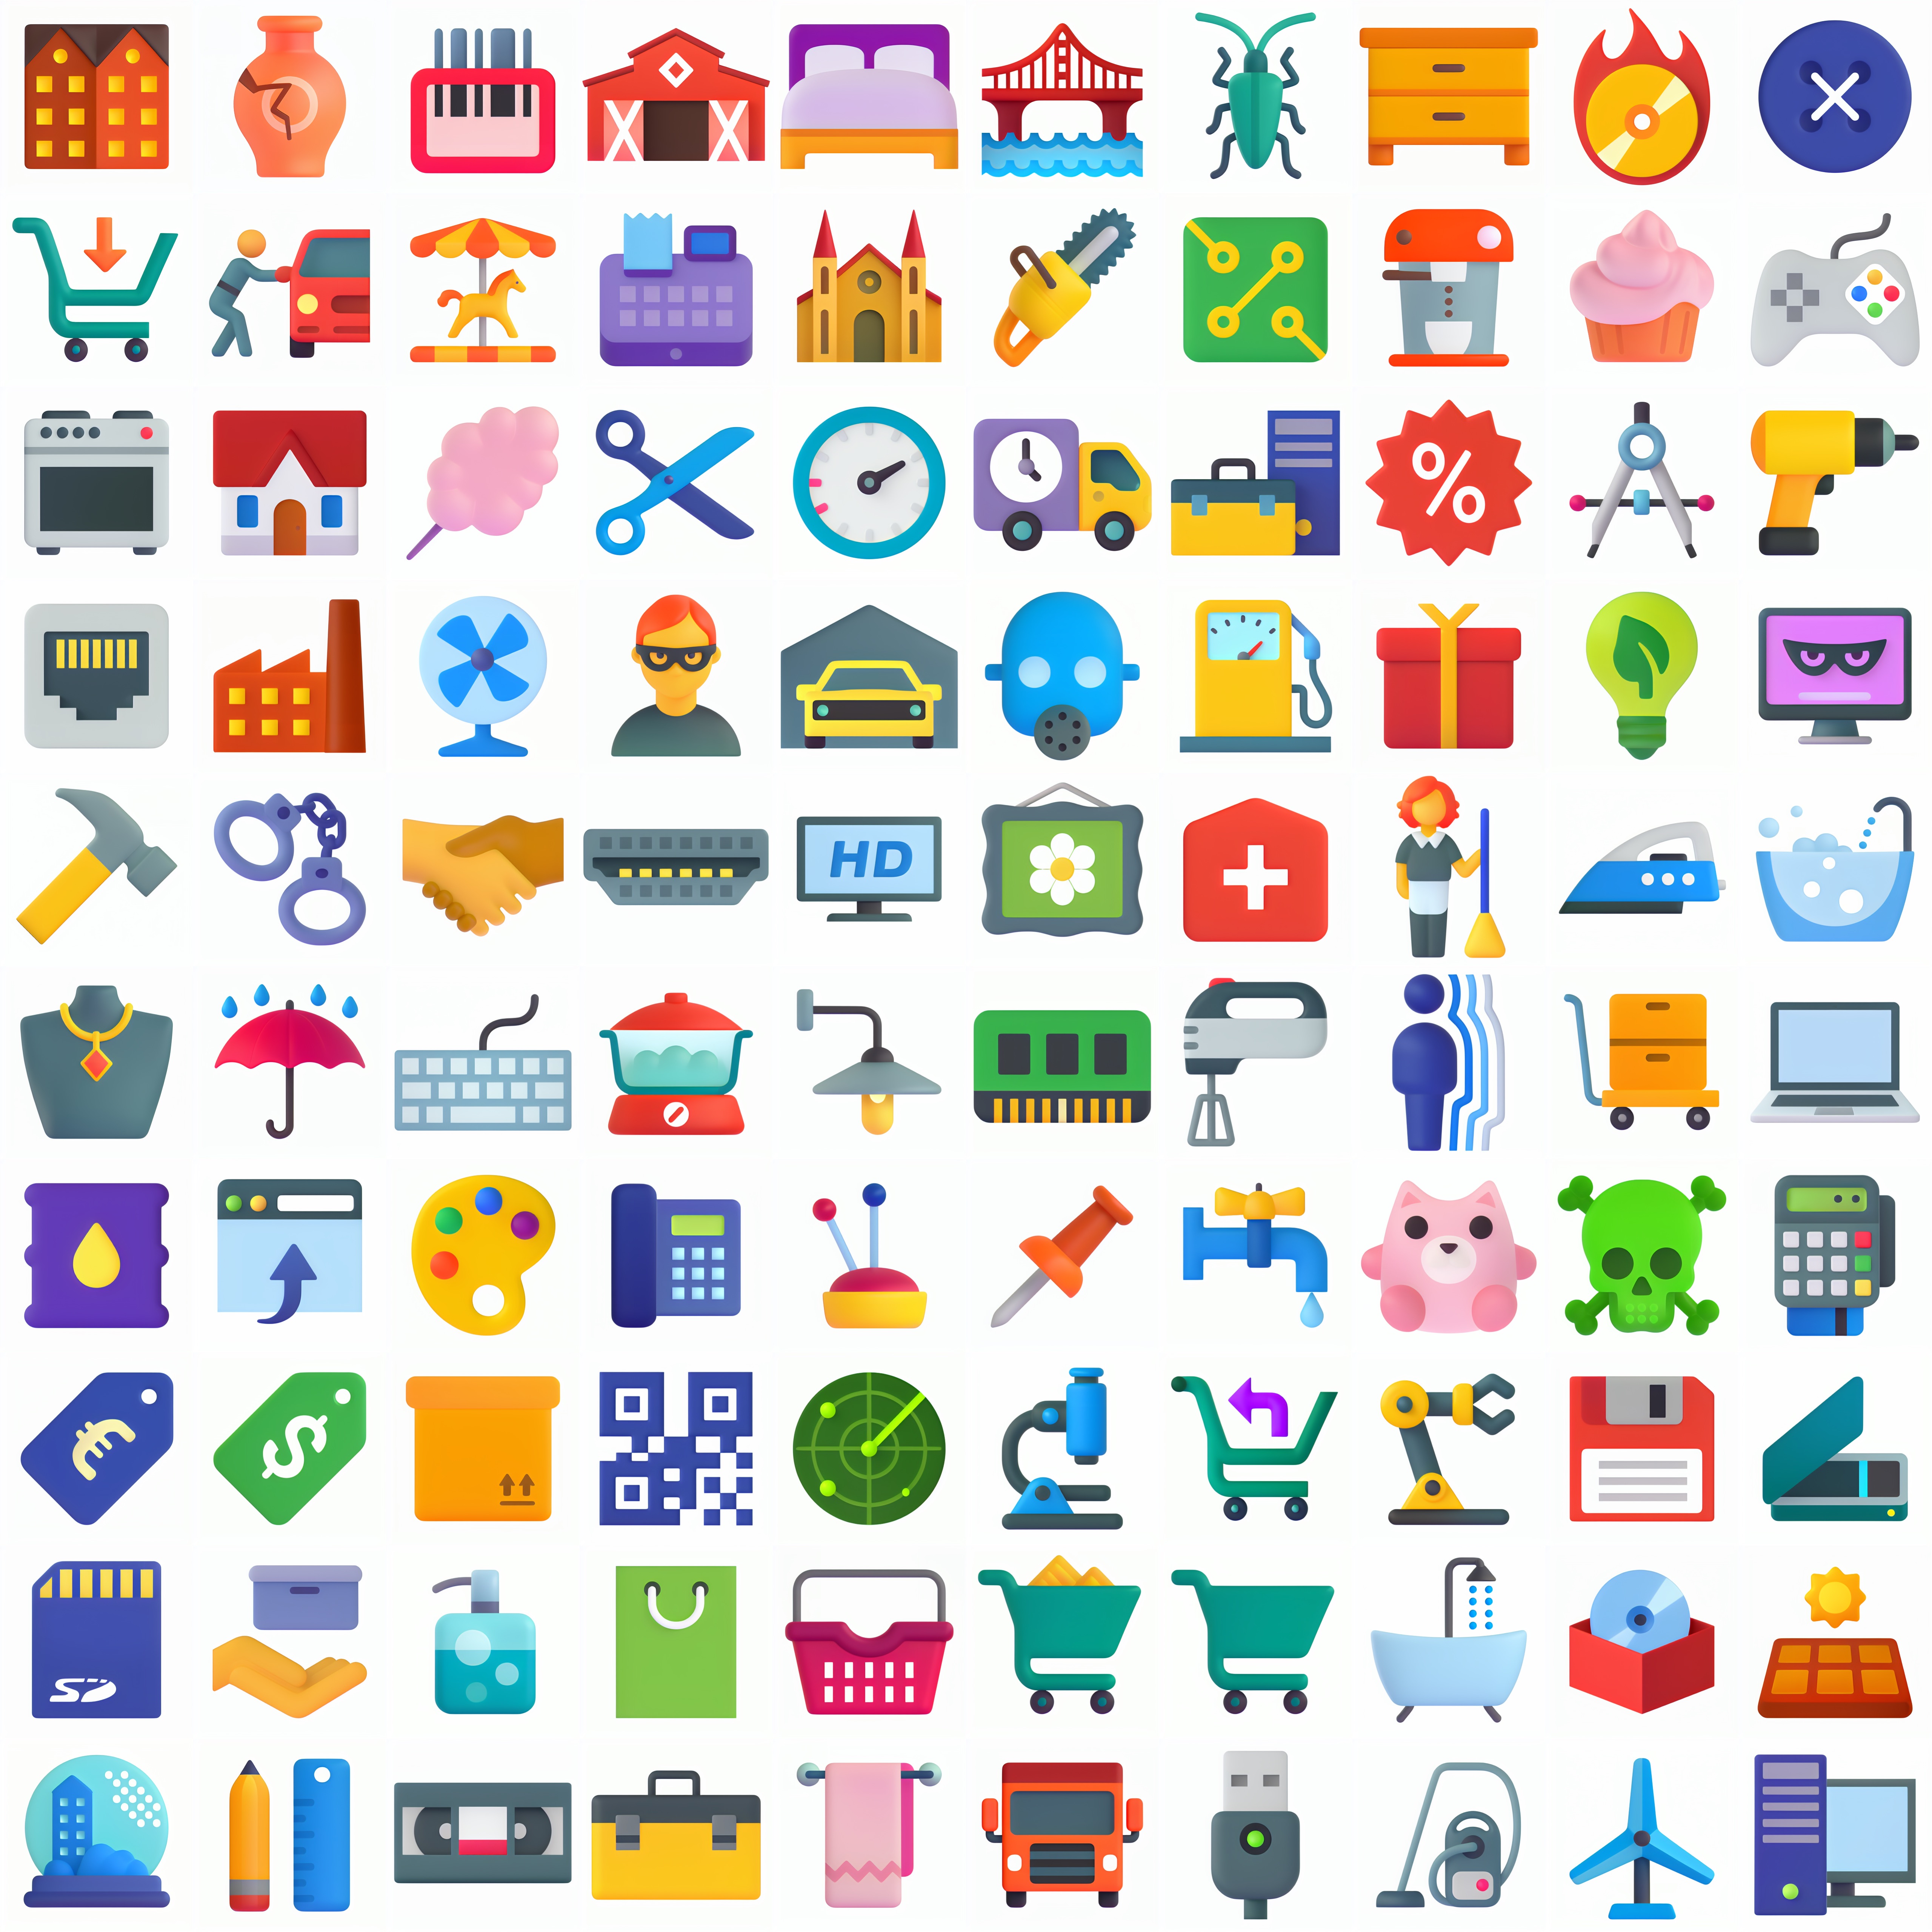
Este es el resultado:

Aquí puedes ver el resultado de convertir 100 iconos 2D a 3D. Fuente.
Resumen
La IA puede acelerar la lluvia de ideas en nuestro día a día, pero le cuesta con los encargos muy específicos. Entrenarla para casos de uso concretos puede resolver este problema.